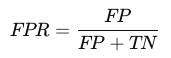Delapan materi, satu alur: dari sejarah dan metodologi, menuju
pengumpulan data, eksplorasi, pembersihan,
rekayasa fitur, pemodelan, hingga evaluasi.
Dijelaskan lengkap, dengan visualisasi yang bergerak mengikuti scroll.
Data science bukanlah ilmu yang lahir tiba-tiba. Ia adalah hasil pertemuan panjang antara
statistika, ilmu komputer, dan kebutuhan nyata manusia
untuk mengambil keputusan berbasis bukti. Memahami sejarahnya membuat kita tahu
mengapa tools hari ini berbentuk seperti sekarang — dan ke arah mana bidang ini bergerak.
DEFINISI DASAR
Apa itu Data Science?
Data science adalah ilmu yang menggunakan data untuk mendapatkan wawasan
(insight) dan membuat keputusan. Ia menggabungkan berbagai disiplin:
statistik, matematika, dan ilmu komputer, lalu ditempelkan pada satu domain masalah
(bisnis, kesehatan, pertanian, keuangan, dan seterusnya).
Perhatikan kata kuncinya: bukan sekadar "mengolah data", tetapi berakhir pada
keputusan. Data yang menumpuk tanpa analisis hanyalah biaya penyimpanan.
Statistika — cara menyimpulkan sesuatu dari sampel, mengukur ketidakpastian, dan menguji hipotesis.
Ilmu komputer — kemampuan menyimpan, memproses, dan menskalakan komputasi atas data besar.
Pengetahuan domain — tahu mana pertanyaan yang layak dijawab dan mana hasil yang masuk akal.
Catatan penting: tanpa pilar ketiga, seorang data scientist bisa menghasilkan
model yang secara statistik rapi tetapi menjawab pertanyaan yang salah.
Garis Waktu Perkembangan Data Science
gulir untuk menelusuri 1960-an → 2020-an
1960-an
Era Data & Statistika
Komputer mulai dipakai untuk analisis data. Bahasa Fortran lahir untuk komputasi ilmiah. Metode statistik tradisional mendominasi.
1962
"The Future of Data Analysis"
John W. Tukey menulis esai yang menggeser fokus statistik dari sekadar pengujian hipotesis menuju eksplorasi data.
1970-an
Basis Data Relasional
Edgar F. Codd (1970) memperkenalkan model relasional. SQL lahir sebagai bahasa manipulasi data yang bertahan hingga kini.
1980-an
PC & Tools Statistik
PC mulai dipasarkan massal. Perangkat lunak statistik seperti SAS dan SPSS membuka analisis data bagi non-programmer.
1990-an
Warehousing, Mining & Internet
Konsep data warehouse diperkenalkan, data mining dipakai mengekstrak pola, dan internet memicu ledakan volume data.
2000-an
Era Big Data
Istilah "Big Data" populer (volume, velocity, variety). Hadoop memungkinkan pemrosesan data besar secara terdistribusi. Data science menjadi profesi tersendiri.
2010-an
ML, AI & Cloud
TensorFlow, PyTorch, scikit-learn. Cloud (AWS, GCP, Azure) dan alat BI seperti Tableau & Power BI jadi standar.
2020-an
Deep Learning, IoT & Etika
Deep learning merambah visi komputer dan NLP. Edge computing & IoT menyatukan data science dengan perangkat fisik. Fokus bergeser ke privasi.
Sumber: materi 1_Sejarah dan Perkembangan Data Science, dilengkapi penelusuran literatur.
Tonggak yang sering terlewat: istilah data science sudah dipakai Peter Naur (1974)
dalam Concise Survey of Computer Methods; C. F. Jeff Wu (1985) memakainya sebagai
usulan nama baru untuk statistika; dan pada 2012 Davenport & Patil menulis
"Data Scientist: The Sexiest Job of the 21st Century" di Harvard Business Review.
1960-an — 1970-an
Dari Statistik ke Data
Komputer menggeser statistik dari hitung manual menjadi komputasi.
Fortran (1957, dikembangkan 1960-an) menjadi bahasa standar komputasi ilmiah.
Codd (1970) — model relasional: data disimpan sebagai tabel, bukan hirarki kaku.
SQL membuat data bisa ditanyai dengan bahasa deklaratif: "apa yang saya mau", bukan "bagaimana caranya".
Warisan era ini masih terasa: setiap SELECT ... WHERE ... GROUP BY
yang Anda tulis hari ini adalah turunan langsung dari gagasan Codd.
1980-an — 1990-an
Demokratisasi & Ledakan Data
PC memindahkan analisis dari mainframe ke meja analis.
SAS dan SPSS menyediakan prosedur statistik siap pakai.
Data warehousing — data operasional dipisahkan dari data analitik agar tidak mengganggu sistem transaksi.
Data mining — pola dicari otomatis, bukan hanya diuji manual.
Internet memicu pertumbuhan volume data secara eksponensial.
Era Big Data
"Big Data" menggambarkan data yang terlalu besar/cepat/bervariasi untuk ditangani alat lama.
Hadoop menjawabnya dengan memecah pekerjaan ke banyak mesin
(MapReduce + HDFS). Di titik ini data science menjadi disiplin yang terpisah,
dan permintaan terhadap data scientist melonjak.
Teknologi & Alat Modern
Machine learning dan AI masuk ke aplikasi sehari-hari. Pustaka seperti
TensorFlow, PyTorch, dan scikit-learn membuat model
kompleks bisa dibangun dalam hitungan baris. Cloud menyediakan komputasi elastis;
Tableau dan Power BI membuat hasil analisis bisa dibaca siapa pun.
Perkembangan Terkini
Deep learning mendominasi visi komputer dan NLP. Edge computing
dan IoT memindahkan inferensi ke dekat sumber data. Isu etika, privasi, dan
keamanan data naik ke permukaan — melahirkan regulasi seperti GDPR di Eropa dan
UU Perlindungan Data Pribadi (UU PDP) di Indonesia.
Peta Alat per Zaman
Periode
Fokus
Alat / Teknologi
Keterampilan Kunci
1960-an
Komputasi statistik
Fortran, mainframe
Metode statistik klasik
1970-an
Penyimpanan terstruktur
DBMS relasional, SQL
Perancangan basis data
1980-an
Analisis di meja kerja
PC, SAS, SPSS
Interpretasi output statistik
1990-an
Integrasi & penambangan
Data warehouse, OLAP, data mining
SQL lanjutan, pemodelan data
2000-an
Skala besar
Hadoop, MapReduce, NoSQL
Pemrograman terdistribusi
2010-an
Prediksi & otomasi
scikit-learn, TensorFlow, PyTorch, cloud, BI
Machine learning, storytelling data
2020-an
AI terapan & tata kelola
LLM, MLOps, edge/IoT, AutoML
Evaluasi model, etika & privasi
TATA KELOLA
Etika, Privasi, dan Regulasi
Semakin banyak keputusan diambil oleh model, semakin besar pula risiko yang menyertainya:
bias data, diskriminasi algoritmik, kebocoran data pribadi.
GDPR (Eropa, 2018) — hak subjek data: tahu, koreksi, hapus, dan menolak pemrosesan otomatis.
UU PDP (Indonesia, UU No. 27/2022) — dasar hukum pemrosesan data pribadi, kewajiban pemberitahuan kebocoran, dan sanksi.
Prinsip minimisasi — kumpulkan hanya data yang benar-benar diperlukan.
KE DEPAN
Tren Masa Depan
AI yang lebih cerdas & adaptif — sistem yang menyesuaikan diri terhadap perubahan pola.
Interdisipliner — kolaborasi dengan bioteknologi, ekonomi, iklim, dan bidang lain.
Quantum computing — potensi memecahkan masalah optimasi/kombinatorial yang saat ini mustahil.
"Lu punya DATA, lu punya KUASA." — Kalimat penutup materi ini bukan sekadar slogan.
Kekuasaan itu netral: ia bisa dipakai untuk mempersempit kesenjangan atau memperlebar bias.
Karena itu kompetensi teknis harus selalu berjalan bersama kesadaran etis.
Masalah paling mahal di data science bukan algoritma yang salah, melainkan pertanyaan yang salah.
Rollins menekankan: terlalu sering banyak usaha dicurahkan untuk menjawab apa yang
dianggap orang sebagai pertanyaan — metodenya benar, tetapi tidak menyelesaikan masalah sebenarnya.
Sepuluh Tahap Metodologi — dan Sifat Iternya
perhatikan panah dua arah: proses ini tidak lurus
01Business understanding
→
02Analytic approach
→
03Data requirements
↔
04Data collection
→
05Data understanding
lanjut ke tahap 06 — dan seterusnya, dengan umpan balik ke belakang
06Data preparation
↔
07Modeling
→
08Evaluation
→
09Deployment
→
10Feedback
↺ Feedback (10) mengalir kembali ke Modeling (07); Data preparation (06) dan Modeling (07) saling menyesuaikan.
Tahap 3↔4 dan 4↔5 berjalan dua arah: kebutuhan data berubah saat kita melihat data,
dan pemahaman data berubah saat koleksi berjalan. Feedback dari tahap 10
mengalir kembali ke modeling — model yang sudah dipakai di produksi akan
memaksa kita kembali memperbaiki, bukan sekadar selesai.
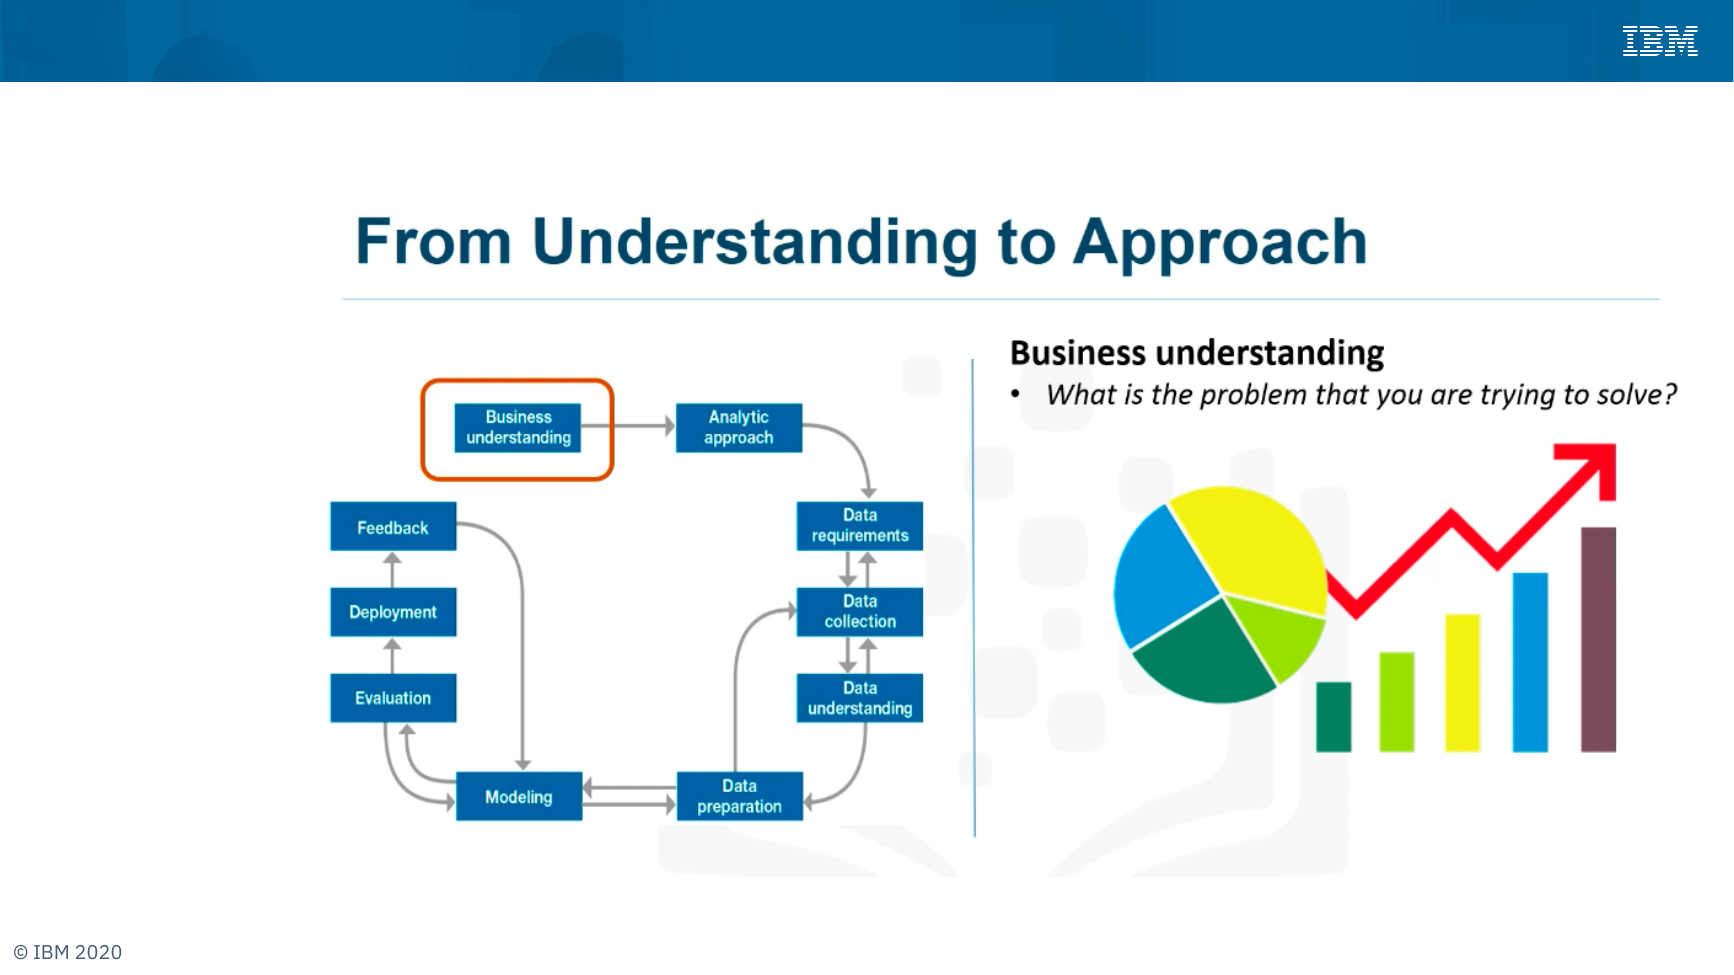
Gambar asli materi. Diagram tahapan metodologi dari slide IBM — Business understanding
(disorot oranye) → Analytic approach → Data requirements ↔ Data collection ↔ Data understanding →
Data preparation ↔ Modeling → Evaluation → Deployment → Feedback → kembali ke Modeling.
TAHAP 01
Business Understanding
Metodologi dimulai dengan meluangkan waktu untuk mencari klarifikasi.
Klarifikasi diletakkan di awal karena hanya dengan kejelasan masalah kita bisa menentukan
data mana yang akan dipakai untuk menjawab pertanyaan inti.
Urutannya: pahami goal orang yang bertanya → turunkan menjadi
objectives → pecah objectives menjadi prioritas yang bisa
direncanakan. Contoh materi: "bagaimana mengurangi biaya aktivitas?"
Goal-nya bisa berarti efisiensi, bisa juga profitabilitas — dua hal berbeda
dengan solusi berbeda.
Peran sponsor bisnis sepanjang proyek: menetapkan arah keseluruhan,
tetap terlibat memberi panduan, dan memastikan dukungan tersedia saat dibutuhkan.
TAHAP 02
Analytic Approach
Setelah pertanyaan dipahami dengan kuat, pilih pendekatan analitiknya. Intinya:
jenis pola apa yang dibutuhkan untuk menjawab pertanyaan itu
seefektif mungkin.
Pertanyaan tentang probabilitas suatu aksi → model predictive.
Pertanyaan tentang hubungan → pendekatan descriptive.
Pertanyaan yang butuh jawaban ya/tidak → classification.
Pertanyaan tentang perilaku manusia → clustering & association.
Pendekatan yang benar selalu bergantung pada kebutuhan bisnis model,
bukan pada algoritma yang paling sedang populer.
Empat Jenis Pendekatan Analitik
Pendekatan
Pertanyaan yang Dijawab
Contoh Keluaran
Teknik Umum
Descriptive
Apa status saat ini?
Ringkasan penjualan bulan ini
Statistik deskriptif, dashboard, agregasi
Diagnostic (Statistical Analysis)
Apa yang terjadi & mengapa?
Penyebab penurunan konversi
Uji hipotesis, analisis korelasi, drill-down
Predictive (Forecasting)
Jika tren berlanjut, apa yang akan terjadi?
Perkiraan permintaan kuartal depan
Regresi, klasifikasi, time series
Prescriptive
Bagaimana kita menyelesaikannya?
Rekomendasi alokasi stok
Optimasi, simulasi, sistem rekomendasi
Urutan ini juga mencerminkan tingkat kesulitan: descriptive paling mudah, prescriptive paling menuntut
karena harus memahami sebab-akibat dan konsekuensi keputusan.
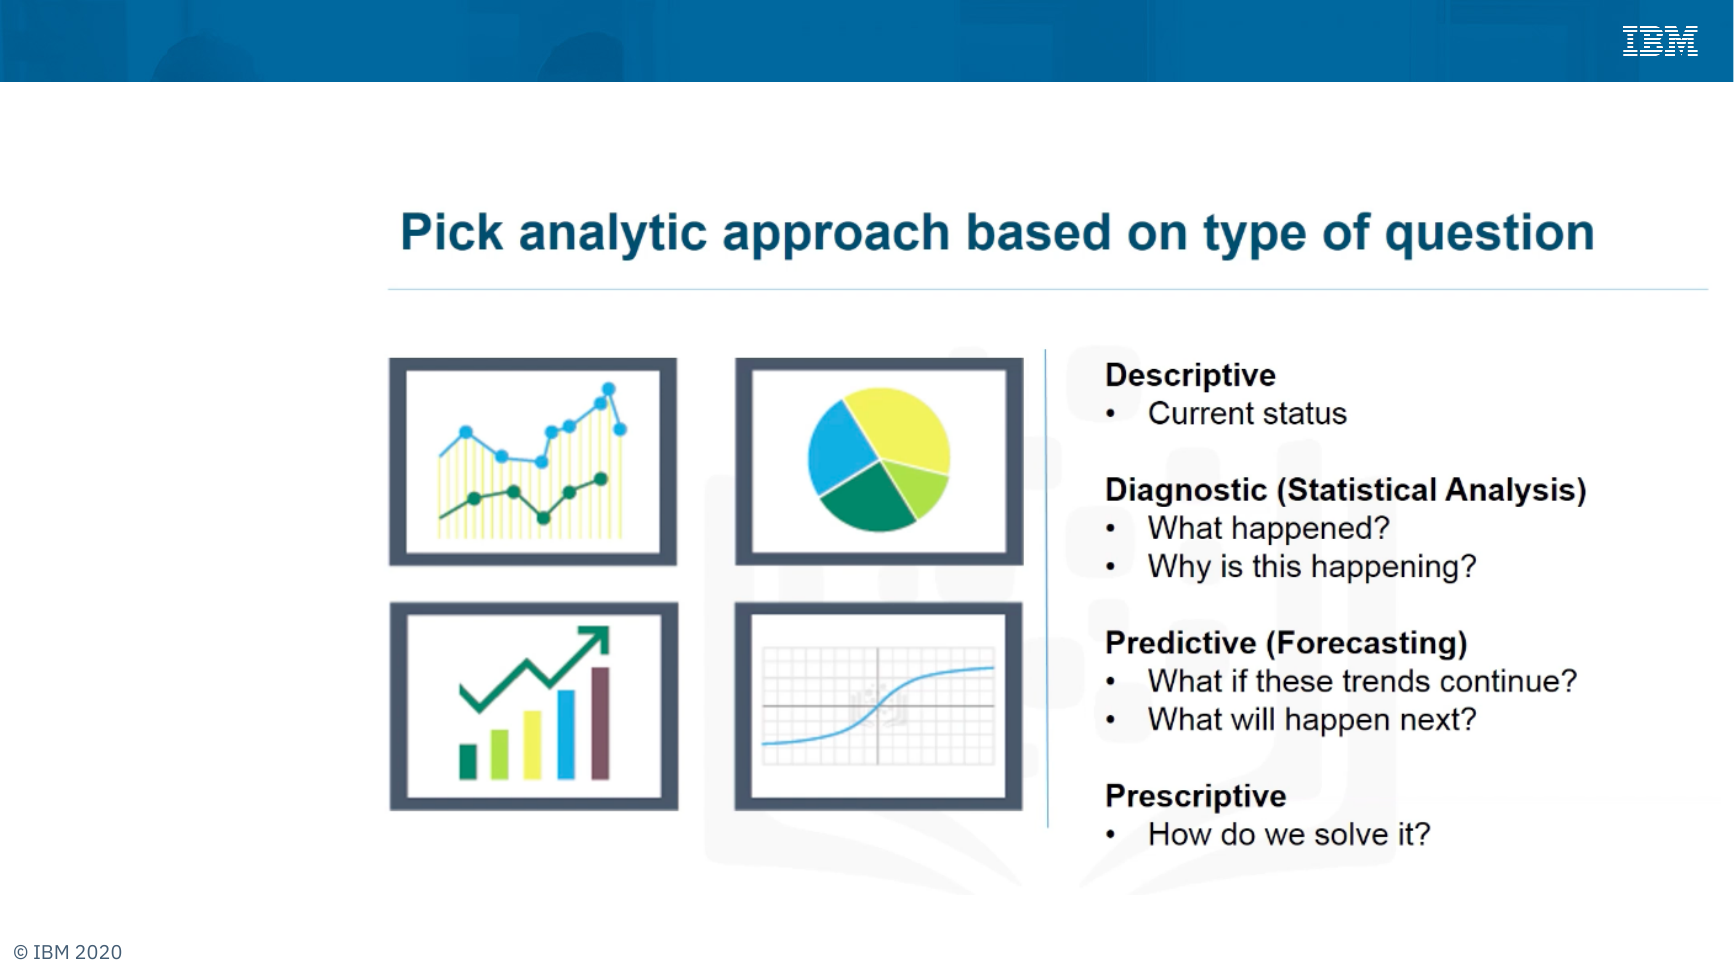
Gambar asli materi. "Pick analytic approach based on type of question" — Descriptive
(status saat ini), Diagnostic/Statistical Analysis (apa & mengapa), Predictive/Forecasting
(apa berikutnya), Prescriptive (bagaimana menyelesaikannya).
STUDI KASUS
Mengapa Decision Tree Dipilih?
Pada kasus readmission pasien, model klasifikasi decision tree dipakai untuk menemukan
kombinasi kondisi yang mengarah pada tiap luaran pasien. Dengan menelusuri variabel di setiap
node sepanjang jalur menuju leaf, diperoleh nilai ambang (threshold) tertentu.
Memberi luaran prediksi sekaligus peluangnya, berdasarkan proporsi kelas dominan di leaf.
Jika kelas dominan "ya", risiko = proporsi "ya" di leaf.
Jika kelas dominan "tidak", risiko = 1 − proporsi "tidak" di leaf.
Mudah dipahami non-data-scientist dan mudah diterapkan untuk memberi skor pasien baru.
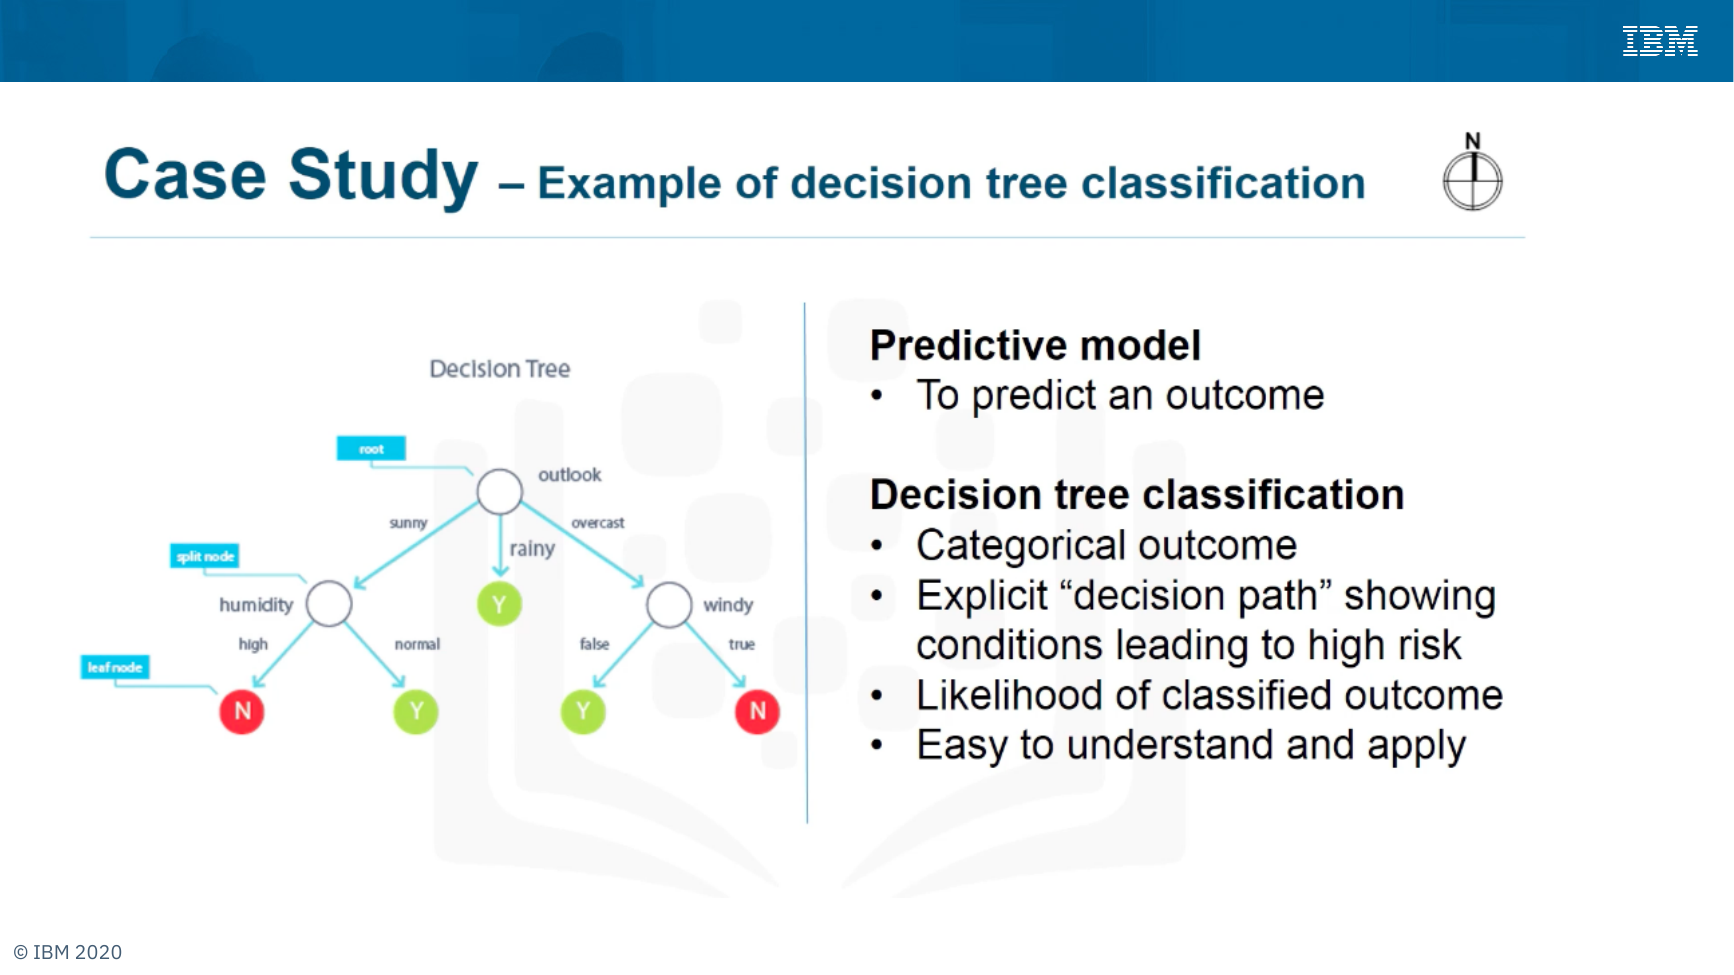
Gambar asli materi. Anatomi decision tree: root node (outlook), split node
(humidity, windy), dan leaf node (Y/N). Aturannya: sunny+high → N; sunny+normal → Y;
rainy → Y; overcast+tidak berangin → Y; overcast+berangin → N.
Delapan Tahap Berikutnya, Ringkas
03
Data Requirements
Menentukan data apa yang dibutuhkan: variabel, granularitas, periode, dan kualitas minimum agar pertanyaan bisa dijawab.
04
Data Collection
Mengambil data dari sumbernya — basis data, API, berkas, sensor, survei — dengan izin dan metode yang tepat.
05
Data Understanding
Melihat isi data yang terkumpul: apakah sesuai harapan? Apakah ada nilai hilang, duplikat, atau anomali?
06
Data Preparation
Membersihkan, mentransformasi, dan menyusun data menjadi bentuk yang siap dimodelkan (sering disebut feature engineering).
07
Modeling
Memilih dan melatih algoritma. Di sinilah iterasi dengan data preparation paling sering terjadi.
08
Evaluation
Mengukur kinerja pada data yang belum pernah dilihat model, dengan metrik yang sesuai tujuan bisnis.
09
Deployment
Menempatkan model di lingkungan nyata agar memberi nilai — sebagai API, batch scoring, atau fitur produk.
10
Feedback
Memantau performa setelah dipakai. Data berubah, model menua; umpan balik mengarahkan perbaikan berikutnya.
Cara membaca metodologi ini: jangan perlakukan sebagai checklist satu arah.
Ia adalah loop. Kesalahan paling umum pemula adalah melompat langsung ke modeling,
lalu bingung ketika hasilnya tidak berguna — padahal masalahnya ada di tahap 1 atau 3.
03Judul Unit Mengumpulkan Data
Dasar-Dasar Data Science: Mengumpulkan Data
Mengumpulkan data adalah langkah awal yang menentukan kualitas seluruh proyek.
Data yang dikumpulkan harus relevan, akurat, dan
representatif terhadap masalah yang ingin diselesaikan.
Salah di tahap ini, semua tahap berikutnya ikut salah — garbage in, garbage out.
Tiga Keluarga Sumber Data
🏢
Internal
Data yang dikumpulkan dan disimpan sendiri oleh organisasi. Sangat spesifik dan relevan dengan operasi.
Database perusahaan — penjualan, inventaris, data pelanggan (DBMS).
Log sistem — log server, aplikasi, transaksi.
Survei internal — wawasan karyawan & stakeholder.
🌐
Eksternal
Data dari luar organisasi; melengkapi data internal dan memberi perspektif lebih luas.
Data publik — sensus, cuaca, data ekonomi (pemerintah, non-profit, riset).
API — pengambilan otomatis (mis. OpenWeather, API media sosial).
Web scraping — mengekstrak data halaman web dengan program (mis. harga e-commerce).
📡
Lainnya
Sumber yang tidak selalu masuk dua kategori di atas, tetapi sering paling kaya.
Data sensor — IoT, sensor lingkungan, perangkat medis.
Data transaksi — kartu kredit, bank, e-commerce.
Data media sosial — posting, komentar, likes, shares.
Alur Data: dari Sumber ke Keputusan
animasi mengikuti scroll
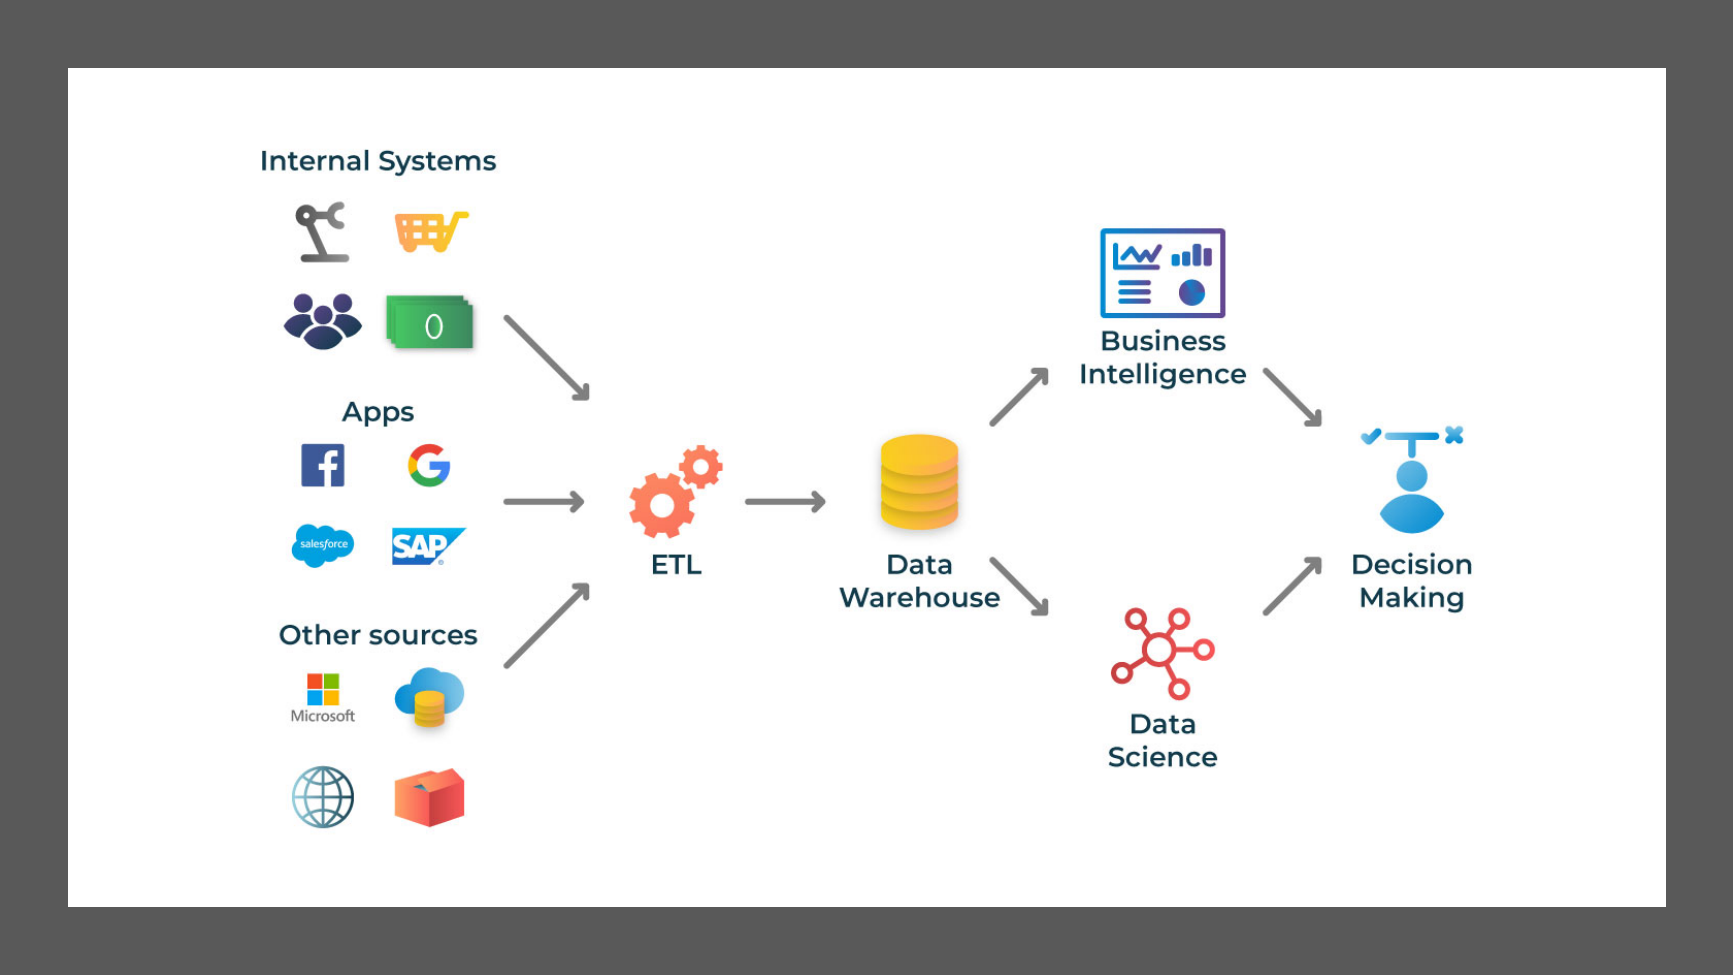
Pola inilah yang membuat data mentah dari banyak sistem bisa dipakai bersama: ETL
menyamakan format, data warehouse menyimpan versi terintegrasi, lalu analitik
mengubahnya menjadi keputusan.
Gambar asli materi. Sumber internal, aplikasi, dan sumber lain → ETL → Data Warehouse →
Business Intelligence & Data Science → Decision Making.
Proses Mengumpulkan Data
TAHAP 1
Identifikasi Kebutuhan Data
Tentukan apa yang ingin dicapai dan pertanyaan kunci yang harus dijawab, lalu jenis data yang diperlukan.
try:
    url = 'https://jsonplaceholder.typicode.com/users'
    response = requests.get(url, timeout=10)

    if response.status_code == 200:
        users = response.json()
        df_users = pd.DataFrame(users)
        print("Data berhasil diambil dari API")
        print(df_users[['id', 'name',
                            'email', 'phone']].head())
    else:
        print(f"Error: status {response.status_code}")

except Exception as e:
    print(f"Error saat mengambil data: {e}")
    print("Pastikan koneksi internet tersedia")
Kesimpulan unit ini. Mengumpulkan data adalah langkah esensial yang melibatkan
identifikasi kebutuhan, identifikasi sumber, akses & ekstraksi, serta pembersihan dan validasi.
Memilih sumber yang tepat dan metode akses yang sesuai adalah prasyarat agar data yang terkumpul
berkualitas tinggi dan relevan dengan tujuan analisis.
04Judul Unit Menelaah & Memvalidasi
Menelaah Data: Exploratory Data Analysis
EDA adalah proses awal dalam analisis data untuk memahami struktur, karakteristik,
dan pola dalam dataset. Ini langkah penting sebelum analisis lanjut atau pembangunan model —
lewat EDA kita mengidentifikasi distribusi, outlier, korelasi, dan anomali.
POSISI DALAM ALUR KERJA
EDA vs Preprocessing
Aspek
EDA
Preprocessing
Tujuan
Memahami & menemukan pola
Menyiapkan data agar siap model
Sifat
Eksploratif, terbuka
Transformatif, terarah
Keluaran
Hipotesis, insight, daftar masalah data
Dataset bersih & ter-transformasi
Contoh aksi
Histogram, korelasi, ringkasan statistik
Imputasi, encoding, scaling
Hubungannya bukan "salah satu", melainkan berurutan: EDA memberi tahu apa yang perlu
diperbaiki, preprocessing mengerjakannya.
EMPAT TEKNIK
Yang Dilakukan Saat EDA
Statistik deskriptif — merangkum pusat, sebaran, dan bentuk distribusi.
Visualisasi data — histogram, scatter, box plot, bar, heatmap.
Analisis korelasi — mengukur kekuatan & arah hubungan linier antar variabel.
Identifikasi pola & anomali — termasuk deteksi outlier dengan z-score atau IQR.
Aturan praktis: sebelum menghitung apa pun, lihat dulu bentuk datanya.
Rata-rata dari distribusi yang sangat miring bisa menyesatkan; median lebih jujur.
Statistik Deskriptif: Tiga Keluarga Ukuran
A · PEMUSATAN
Mean, Median, Modus
Mean — jumlah semua nilai dibagi jumlah data.
x̄ =Σ xin
Median — nilai tengah setelah data diurutkan; tahan terhadap outlier.
Modus — nilai yang paling sering muncul; bisa unimodal, bimodal, atau multimodal.
B · PENYEBARAN
Range, Variansi, Standar Deviasi, IQR
Range = maks − min. Paling sederhana, tetapi sangat dipengaruhi satu nilai ekstrem.
s² =Σ (xi − x̄)²n − 1s = √s²
Standar deviasi punya satuan sama dengan data asli, jadi lebih mudah ditafsirkan
daripada variansi (yang satuannya kuadrat).
IQR = Q3 − Q1, rentang tengah 50% data; dasar deteksi outlier.
C · BENTUK DISTRIBUSI
Skewness & Kurtosis
Skewness mengukur asimetri distribusi:
Positif — ekor memanjang ke kanan; mean > median > modus.
Negatif — ekor memanjang ke kiri; mean < median < modus.
Nol — simetris (seperti distribusi normal); mean = median = modus.
Kurtosis mengukur "ketebalan ekor" — seberapa sering nilai ekstrem muncul.
Tiga Bentuk Distribusi — dan Posisi Mean vs Median
garis putus-putus: posisi mean & median
Pada skew positif, segelintir nilai besar "menarik" mean ke kanan, sementara median tetap dekat
ke pusat massa data. Karena itu median lebih robust terhadap outlier.
Box Plot & Lima Statistik
IQR = Q3 − Q1
Box plot merangkum lima statistik: minimum, Q1, median (Q2), Q3, maksimum.
Nilai di luar pagar Q1 − 1.5·IQR dan Q3 + 1.5·IQR
ditandai sebagai outlier.
Kapan Memakai Ukuran yang Mana?
Situasi
Pusat
Sebaran
Data simetris, tanpa outlier
Mean
Std. deviasi
Miring / ada outlier
Median
IQR
Data kategorikal
Modus
—
Ini bukan aturan kaku, tetapi default yang aman. Selalu laporkan lebih dari satu ukuran
ketika data tidak jelas bentuknya.
Lima Visualisasi Inti
Visualisasi membantu memahami distribusi, pola, dan hubungan melalui representasi grafis.
Pilih bentuk sesuai pertanyaan: bagaimana sebarannya? → histogram;
bagaimana hubungan dua variabel? → scatter; di mana outlier? → box plot.
Histogram — Distribusi Frekuensi
satu variabel, banyak bin
0255075100
Histogram mengelompokkan nilai ke dalam bin dan menampilkan frekuensinya. Bentuk yang muncul
langsung memberi tahu apakah data simetris, miring, atau punya dua puncak.
Scatter Plot — Hubungan Dua Variabel Numerik
setiap titik = satu pengamatan
Posisi horizontal (x) dan vertikal (y) ditentukan nilai dua variabel. Pola naik menandakan
korelasi positif, pola turun korelasi negatif, dan sebaran acak menandakan tidak ada hubungan linier.
Heatmap Korelasi
warna = kekuatan & arah hubungan
positif kuatnetralnegatif
Sel diagonal selalu 1 (variabel berkorelasi sempurna dengan dirinya sendiri). Matriks simetris,
jadi separuh sel sebenarnya duplikat.
Bar Plot & Kapan Dipakai
Bar plot menampilkan data kategorikal: setiap batang satu kategori, dan tinggi/panjang
batang menunjukkan ukuran atau frekuensinya. Cocok untuk membandingkan jumlah transaksi per kota,
jumlah pelanggan per segmen, dan sejenisnya.
Visualisasi
Jawab Pertanyaan
Histogram
Bagaimana distribusi satu variabel numerik?
Scatter plot
Bagaimana hubungan dua variabel numerik?
Box plot
Di mana median, sebaran, dan outlier?
Bar plot
Bagaimana perbandingan antar kategori?
Heatmap
Bagaimana pola korelasi banyak variabel sekaligus?
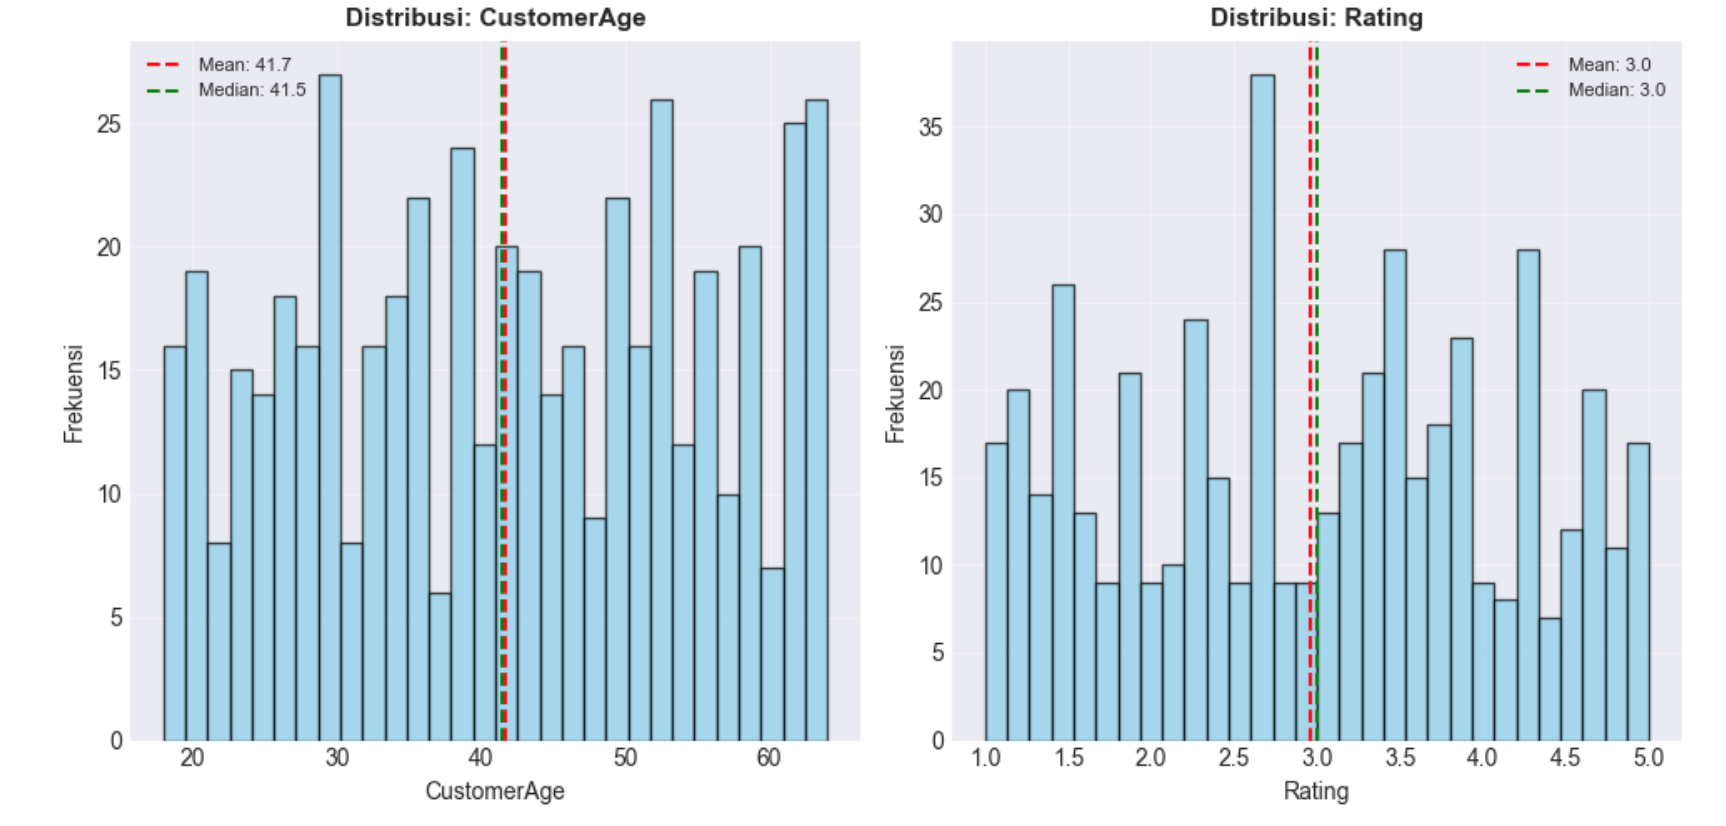
Gambar asli materi. Histogram CustomerAge (mean 41.7 / median 41.5 — hampir
berimpit, distribusi relatif simetris) dan Rating (mean = median = 3.0). Ketika mean dan median
hampir sama, distribusi cenderung simetris; ketika berbeda jauh, ada kemiringan.
ANALISIS KORELASI
Mengukur Kekuatan & Arah Hubungan
Korelasi mengukur hubungan linier antara dua variabel, bernilai antara −1 dan 1:
positif (naik bersama), negatif (berlawanan), nol (tidak ada hubungan linier).
Pastikan dataset lengkap; tangani missing value pada kolom yang dianalisis.
Hitung matriks korelasi (df.corr()).
Visualisasikan dengan heatmap agar pola mudah dibaca.
Interpretasikan: kekuatan, arah, dan kemungkinan multikolinearitas.
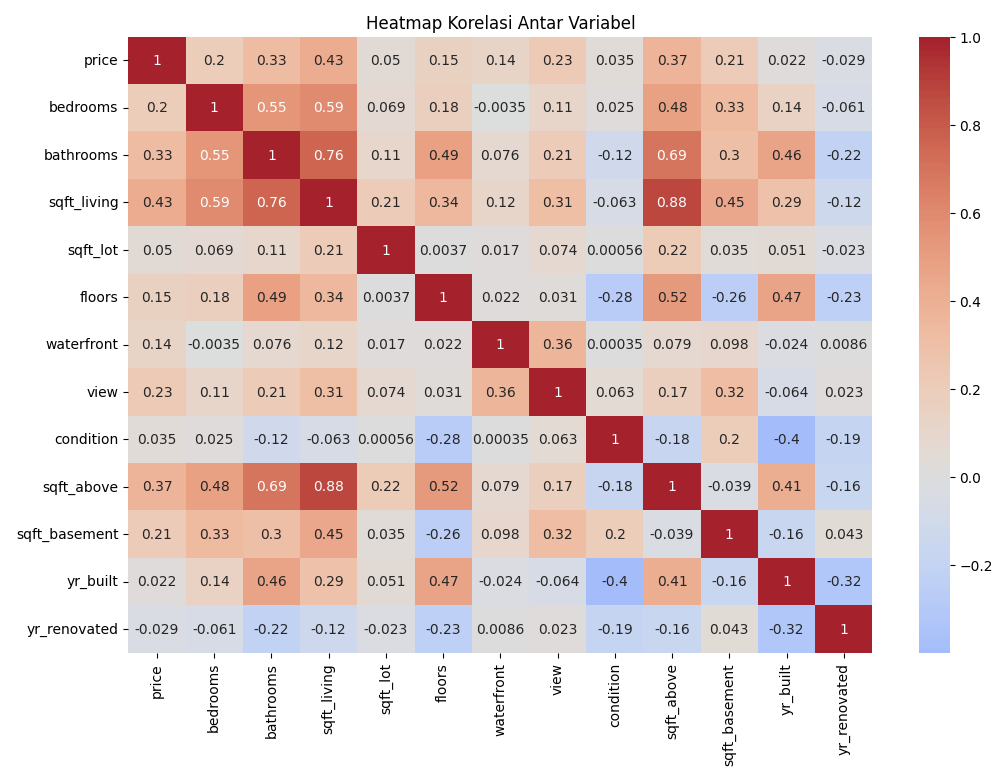
Gambar asli materi. Heatmap 13 variabel perumahan. sqft_living
vs sqft_above = 0.88 (sangat kuat, nyaris redundan); price
paling berkorelasi dengan sqft_living (0.43). Perhatikan juga korelasi negatif
condition vs yr_built (−0.40).
Korelasi bukan kausalitas. Dua variabel bisa berkorelasi tinggi karena kebetulan,
karena sama-sama dipengaruhi variabel ketiga, atau karena tren waktu. Korelasi hanya menunjukkan
hubungan linier, bukan mekanisme penyebab.
Mengidentifikasi Pola & Anomali dengan Z-Score
Z-score mengukur seberapa jauh sebuah titik data menyimpang dari rata-rata, dalam satuan
standar deviasi. Nilai |z| > 3 umum dipakai sebagai penanda outlier.
z =x − μσ
zscore_outliers.py
from scipy import stats

zscore_info = []
for col in numeric_cols_sample:
    if col in df.columns:
        z = np.abs(stats.zscore(df[col].dropna()))
        n_out = len(z[z > 3])
        zscore_info.append({
            'Kolom': col,
            'Jumlah Outliers (Z>3)': n_out,
            'Persentase (%)': f("{n_out / len(df) * 100:.2f}")
        })

print(pd.DataFrame(zscore_info).to_string(index=False))
Dua Cara Umum Menandai Outlier
Metode
Aturan
Cocok Untuk
Z-score
|z| > 3
Data mendekati normal
IQR
< Q1−1.5·IQR atau > Q3+1.5·IQR
Data miring / robust
Outlier ≠ error. Sebelum membuang, tanyakan dulu: apakah ini kesalahan input,
atau memang kejadian nyata yang justru penting (mis. transaksi penipuan)?
Memvalidasi Data
Validasi data adalah proses memastikan data yang dipakai dalam analisis atau model
memenuhi kriteria kualitas: akurat, konsisten, dan lengkap.
Tanpa validasi, model bisa dilatih di atas data yang tampak rapi tetapi secara diam-diam salah.
DIMENSI 1
Validity
Nilai sesuai aturan/constraint: tipe data, rentang, wajib isi, unik, keanggotaan himpunan, foreign key, pola regex, dan validasi lintas kolom.
DIMENSI 2
Accuracy
Kedekatan nilai dengan kenyataan. Paling sulit diperbaiki karena butuh sumber "gold standard" eksternal.
DIMENSI 3
Completeness
Semua ukuran yang wajib diketahui benar-benar terisi. Ketiadaan data tidak bisa "ditebak" tanpa asumsi.
DIMENSI 4
Consistency & Uniformity
Tidak ada dua nilai yang saling bertentangan, dan satuan/format seragam di semua sistem (kg vs pound, DD-MM vs MM-DD).
Jenis Validasi yang Umum
Tipe data — kolom numerik tidak boleh berisi teks seperti "tiga puluh".
Rentang — usia tidak boleh −5 atau 150.
Wajib isi — kolom kunci tidak boleh kosong.
Keunikan — ID pelanggan tidak boleh ganda.
Format — email, nomor HP, tanggal mengikuti pola tertentu.
Lintas kolom — tanggal lahir tidak boleh di masa depan; usia harus konsisten dengan tanggal lahir.
Bagaimana Mengatasi Masalahnya?
Koreksi langsung — perbaiki format (mis. 0812-3456-7890 → 081234567890).
Imputasi — isi nilai hilang dengan mean/median/mode, atau model (KNN, regresi).
Hapus — buang baris duplikat atau kolom dengan mayoritas kosong.
Tandai, jangan tebak — jika kebenaran tidak bisa diketahui, simpan status unknown alih-alih mengarang nilai.
Contoh Data Kotor dan Penandaan Masalahnya
CustomerID
Email
Phone
Age
BirthDate
Salary
Membership
1
budi@email.com
081234567890
25
1998-01-15
5000000
Gold
2
ani.wijaya@email.com
08223456789
-5
2030-05-20
3000000
Silver
3
invalid-email
08123
150
1873-03-10
-1000000
Platinum
4
doni@email.com
081345678901234
30
1993-06-05
8000000
Bronze
10
(kosong)
081234567890
25
1998-07-10
5500000
Silver
10
irma@email.com
081234567890
25
1998-07-10
5500000
Silver
12
kiki@email.com
081234567890
"tiga puluh"
invalid-date
10000000
VIP
Merah = melanggar aturan validasi · abu-abu = nilai hilang · CustomerID 10 muncul dua kali
(duplikasi kunci) · Membership berisi nilai di luar himpunan sah
(Gold, Silver, Platinum, Bronze).
validate_email.py
import re
defvalidate_email(email):
"""Validasi format email menggunakan regex"""if pd.isna(email) or email == '':
returnFalse
pattern = r'^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$'returnbool(re.match(pattern, str(email)))
df_customers['Email_Valid'] = df_customers['Email'].apply(validate_email)
invalid = df_customers[~df_customers['Email_Valid']]
iflen(invalid) > 0:
print(f"Ditemukan {len(invalid)} email tidak valid")
print(invalid[['CustomerID', 'Name', 'Email']])
cross_field_check.py
# Konversi BirthDate, lalu hitung usia dari tanggal
df_customers['BirthDate_dt'] = pd.to_datetime(
    df_customers['BirthDate'], errors='coerce')

current_year = datetime.now().year
df_customers['CalculatedAge'] = (
    current_year - df_customers['BirthDate_dt'].dt.year)

df_customers['Age_numeric'] = pd.to_numeric(
    df_customers['Age'], errors='coerce')

# Toleransi 1 tahun untuk pembulatan
df_customers['Age_Consistent'] = (
    abs(df_customers['Age_numeric']
        - df_customers['CalculatedAge']) <= 1)

inconsistent = df_customers[
    (~df_customers['Age_Consistent']) &
    (df_customers['Age_numeric'].notna()) &
    (df_customers['CalculatedAge'].notna())]
Pola Validasi yang Sering Dipakai
Data
Pola / Aturan
Contoh Gagal
Email
^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$
fajar@
No. HP Indonesia
^08\d{8,11}$
08123
Rentang tanggal
df[df['date'] > datetime.now()]
tanggal lahir 2030
Rentang numerik
0 <= age <= 120
usia −5 / 150
Himpunan nilai
isin(['Gold','Silver',...])
VIP, Diamond
Validasi Model: Split & Cross-Validation
Validasi bukan hanya soal isi sel. Model juga harus divalidasi pada data yang belum pernah
dilihatnya — jika tidak, kita hanya mengukur kemampuan menghafal.
5-Fold Cross-Validation
trainvalidasi
Kesimpulan unit ini. Validasi data adalah langkah kritis: dengan metode dan teknik
yang tepat kita memastikan data akurat, konsisten, dan sesuai tujuan. Praktik seperti
splitting dan cross-validation membuat evaluasi model lebih jujur dan hasil analisis
lebih dapat diandalkan.
05Judul Unit Objek Data & Pembersihan
Memahami Objek Data dan Membersihkan Data
Sebelum menyentuh algoritma, kita harus tahu apa yang sedang kita analisis.
Objek data adalah unit dasar yang menjadi fokus analisis; salah mengenalinya, seluruh
proses berikutnya jadi kabur. Setelah itu, data mentah hampir selalu kotor — dan
pembersihan adalah harga yang harus dibayar untuk hasil yang bisa dipercaya.
DEFINISI
Apa Itu Objek Data?
Objek data adalah entitas atau item yang diamati, diukur, atau diprediksi
dalam dataset — unit dasar yang menjadi fokus analisis atau model prediksi.
Setiap objek biasanya punya beberapa fitur/atribut yang menggambarkan
karakteristiknya.
Contoh: dalam dataset perumahan, objek datanya adalah "rumah".
Setiap baris mewakili satu rumah; kolom berisi fitur seperti harga, luas bangunan,
jumlah kamar tidur.
Satu baris = satu objek. Satu kolom = satu fitur. Jika Anda bingung menentukan objek,
tanyakan: "satu baris ini mewakili apa?"
Kesimpulan bagian objek data. Tanpa pemahaman jelas tentang objek data,
analisis menjadi kabur, kurang terfokus, dan bisa menghasilkan wawasan yang salah.
Karena itu setiap proyek sebaiknya dimulai dengan mengidentifikasi objek data secara eksplisit.
Membersihkan Data
Pembersihan data adalah proses sistematis untuk mengidentifikasi dan memperbaiki data yang
tidak valid atau tidak akurat: mengisi nilai hilang, menghapus duplikasi, memperbaiki
inkonsistensi, dan menangani outlier.
Empat Masalah Klasik — dan Penanganannya
animasi: sel bermasalah disorot lalu diperbaiki
MASALAH 1
Missing Values
Isi dengan mean/median/mode, hapus baris/kolom, atau imputasi lanjutan (KNN, regresi).
MASALAH 2
Duplikasi
duplicated() untuk mendeteksi, drop_duplicates() untuk menghapus.
MASALAH 3
Inkonsistensi
Samakan format tanggal, satuan, dan penulisan kategori ("NYC" vs "New York City").
MASALAH 4
Outlier
Deteksi dengan IQR/z-score, lalu hapus, batasi (winsorize), atau biarkan bila bermakna.
Keempat masalah ini bukan kasus langka — pada data dunia nyata, hampir selalu ada.
Urutan penanganan yang wajar: missing → duplikat → inkonsistensi → outlier,
karena duplikat dan inkonsistensi bisa mengacaukan statistik yang dipakai untuk mendeteksi outlier.
imputation.py
# Mean imputation untuk numerik simetris
age_mean = df_simple['Age'].mean()
df_simple['Age'] = df_simple['Age'].fillna(age_mean)
# Median untuk data miring (income)
income_median = df_simple['Income'].median()
df_simple['Income'] = df_simple['Income'].fillna(income_median)
# Mode untuk kategorikalfor col in ['ProductCategory', 'MembershipLevel', 'City']:
if df_simple[col].isnull().any():
mode_val = df_simple[col].mode()[0]
df_simple[col] = df_simple[col].fillna(mode_val)
print(f"{col} diisi dengan: {mode_val}")
duplicates_consistency.py
# 1. Deteksi & hapus duplikatprint("Duplikat:", df.duplicated().sum())
df = df.drop_duplicates()
# 2. Samakan format tanggal
df['tanggal'] = pd.to_datetime(
df['tanggal'], errors='coerce')
# 3. Normalisasi kategori
df['kota'] = (df['kota']
.str.strip()
.str.title()
.replace({'Nyc': 'New York City'}))
# 4. Periksa tipe data akhirprint(df.dtypes)
print(df.isnull().sum())
Mengapa Pembersihan Penting?
Kualitas data yang buruk menghasilkan kesimpulan yang tidak akurat atau menyesatkan.
Model yang dilatih pada data kotor akan "belajar" kesalahan tersebut, lalu
mereproduksinya pada data baru — dengan keyakinan yang menipu.
Kapan Berhenti Membersihkan?
Pembersihan bukan tujuan, melainkan sarana. Berhenti ketika data sudah cukup baik
untuk menjawab pertanyaan — bukan ketika data "sempurna". Terlalu agresif membuang data
bisa menghilangkan sinyal yang justru penting.
Dokumentasikan
Catat setiap keputusan: berapa baris dihapus, metode imputasi apa yang dipakai, dan
mengapa. Tanpa catatan, analisis tidak bisa direproduksi — dan sulit dipertahankan
ketika ditanya "angka ini dari mana?".
Kesimpulan unit ini. Data yang bersih dan terstruktur memungkinkan analisis lebih akurat,
prediksi lebih baik, dan hasil lebih dapat diandalkan. Mengikuti langkah pembersihan secara konsisten
adalah cara paling murah untuk meningkatkan kualitas proyek data science.
06Judul Unit Mengkonstruksi Data
Mengkonstruksi Data (Feature Engineering)
Mengkonstruksi data adalah proses memodifikasi dan menyiapkan data mentah agar lebih siap
dipakai untuk analisis atau pemodelan — melalui transformasi data,
rekayasa fitur, dan agregasi.
"Applied machine learning is basically feature engineering." — Andrew Ng.
Kalimat ini merangkum satu kenyataan: dengan algoritma yang sama, kualitas fitur sering
menentukan selisih antara model biasa dan model yang benar-benar berguna.
KOMPONEN 1
Transformasi Data
Mengubah data dari satu format/skala ke format lain: normalisasi agar skala seragam,
atau transformasi logaritmik untuk mengurangi kemiringan.
KOMPONEN 2
Rekayasa Fitur
Menciptakan fitur baru dari data yang ada — menggabungkan fitur, membuat fitur derivatif,
atau mengurangi jumlah fitur dengan teknik seperti PCA.
KOMPONEN 3
Agregasi Data
Mengelompokkan dan merangkum: rata-rata harga rumah per kota, jumlah transaksi per bulan —
untuk melihat tren yang lebih besar.
1 · Meningkatkan Akurasi Model
Fitur yang relevan menambah informasi yang tidak ada pada fitur asli. Contoh: menambahkan
price_per_sqft memberi model informasi yang tidak diperoleh dari
harga atau luas secara terpisah. Normalisasi/standardisasi juga membuat model bekerja lebih efisien.
2 · Mempersiapkan Data untuk Analisis
Transformasi menyelaraskan format sehingga analisis konsisten. Contoh: menyeragamkan format
tanggal, lalu membuat sales_quarter untuk melihat pola musiman.
Rekayasa fitur juga mengurangi noise.
3 · Mengurangi Kompleksitas
Reduksi dimensionalitas (PCA, pemilihan fitur) memangkas jumlah fitur tanpa kehilangan
informasi penting, sehingga komputasi lebih ringan dan model lebih mudah dipahami.
Agregasi juga menyederhanakan dataset.
Normalisasi vs Standardisasi
Keduanya menyamakan skala, tetapi tujuannya berbeda. Pilih berdasarkan algoritma dan bentuk distribusi.
Normalisasi (Min–Max)
Mengubah data ke rentang seragam, biasanya 0 sampai 1.
x' =x − xminxmax − xmin
Kapan: ketika skala variabel berbeda jauh dan semua fitur harus berkontribusi merata.
Cocok untuk KNN dan neural network.
Sensitif terhadap outlier: satu nilai ekstrem bisa "memampatkan" seluruh data lain ke ujung rentang.
Standardisasi (Z-Score)
Mengubah data agar memiliki mean 0 dan standar deviasi 1.
z =x − μσ
Kapan: data berdistribusi normal atau hampir normal, dan algoritma butuh data
terpusat di sekitar rata-rata. Cocok untuk SVM, regresi, PCA.
Z-score menunjukkan jarak dari rata-rata dalam satuan standar deviasi: negatif = di bawah rata-rata,
positif = di atas rata-rata.
Efek Scaling pada Sebaran Nilai
dua fitur dengan satuan berbeda
Sebelum — Harga (Rp) vs Jumlah Terjual
Sesudah Min–Max — keduanya di rentang 0–1
HargaJumlah terjual
Tanpa scaling, fitur dengan angka besar (harga jutaan) mendominasi perhitungan jarak, sehingga
fitur dengan angka kecil (jumlah unit) praktis diabaikan model. Min–Max menyetarakan keduanya.
Produk
Harga (Rp)
Terjual
Harga Norm.
Terjual Norm.
A
10
100
0.00
0.00
B
30
300
0.40
0.40
C
60
600
1.00
1.00
Contoh materi: A = (10−10)/(60−10) = 0.00; B = (30−10)/50 = 0.40; C = 1.00.
Mahasiswa
Nilai
Mean kelas
Std. dev
Z-score
A
60
75
10
−1.5
B
75
75
10
0.0
C
90
75
10
1.5
(60−75)/10 = −1.5 artinya nilai A berada 1,5 standar deviasi di bawah rata-rata kelas.
Data transaksi sering right-skewed: mayoritas nilai kecil, sedikit nilai sangat besar.
Logaritma memperkecil jarak antar nilai besar sehingga distribusi lebih simetris.
Produk
Transaksi
log10(x)
A
10
1.000
B
100
2.000
C
1.000
3.000
D
10.000
4.000
Setiap kenaikan 10× hanya menambah 1 pada skala log — inilah inti "kompresi"-nya.
Kurva log10(x)
nilai besar terkompresi
Logaritma berguna untuk variabel seperti pendapatan, jumlah transaksi, dan populasi.
Perhatikan: ia tidak bisa dipakai pada nilai 0 atau negatif tanpa penyesuaian
(log1p = log(1+x) mengatasi nol).
Algoritma bekerja dengan angka, bukan teks. Encoding adalah jembatan — tetapi pilihan metodenya
membawa konsekuensi makna.
Label Encoding
Setiap kategori diubah menjadi bilangan bulat unik. Cocok untuk data ordinal
— kategori yang punya urutan bermakna.
Contoh:['low','medium','high'] → [0,1,2].
Jangan pakai untuk data nominal. Memberi angka pada warna
("Merah"=0, "Biru"=1) menciptakan urutan palsu yang bisa dibaca model sebagai
"Biru lebih besar dari Merah".
One-Hot Encoding
Setiap kategori menjadi kolom biner (0/1). Cocok untuk data nominal —
tidak ada urutan antar kategori.
Contoh:['red','blue','green'] → tiga kolom: red, blue, green.
Konsekuensinya dimensi bertambah. Untuk kategori dengan ratusan nilai (mis. kota),
one-hot bisa meledak — pertimbangkan target encoding atau hashing.
Perbandingan pada Data Keanggotaan
urutan Reguler < Silver < Gold bermakna
Pelanggan
Kategori
Label
One-hot: Reguler
One-hot: Silver
One-hot: Gold
P1
Reguler
0
1
0
0
P2
Silver
1
0
1
0
P3
Gold
2
0
0
1
Keduanya menyimpan informasi yang sama, tetapi dengan bentuk berbeda: label encoding
memampatkan urutan menjadi satu kolom, one-hot menyebarkannya menjadi beberapa kolom biner.
Binning mengelompokkan nilai numerik menjadi beberapa kategori (bin). Manfaatnya: lebih stabil
terhadap noise/outlier, lebih mudah diinterpretasi, cocok untuk algoritma yang menyukai data
kategorikal (Naïve Bayes, decision tree), dan memudahkan visualisasi.
Equal Width (Fixed-width)
Rentang nilai dibagi menjadi interval dengan lebar sama.
Interval
Kategori
40 – 56.67
Rendah
56.67 – 73.33
Sedang
73.33 – 90
Tinggi
Kelemahan: jika data menumpuk di satu rentang, sebagian bin bisa hampir kosong.
Equal Frequency (Quantile)
Data dibagi sehingga jumlah observasi tiap kelompok kurang lebih sama.
Dengan 10 mahasiswa dan 3 kelompok, tiap kelompok berisi sekitar 3–4 mahasiswa —
terlepas dari lebar intervalnya.
Lebih tahan terhadap distribusi yang miring, tetapi batas bin menjadi tidak "bulat"
dan lebih sulit dijelaskan ke pemangku kepentingan.
Binning pada Data Nilai Ujian
10 mahasiswa, 3 kategori
40455060657075808590
RendahSedangTinggi
Equal width: 4 nilai masuk "Rendah", 3 "Sedang", 3 "Tinggi". Equal frequency (qcut) membagi
berdasarkan peringkat: 40–60 jadi Rendah, 65–75 Sedang, 80–90 Tinggi. Perhatikan bahwa
hasilnya bisa berbeda meski datanya sama — pilihan metode adalah keputusan analitis.
equal_width.py
nilai = [40, 45, 50, 60, 65, 70, 75, 80, 85, 90]
df = pd.DataFrame({"Nilai": nilai})

# Equal width: bagi rentang jadi 3 bin
df["Kategori"] = pd.cut(
    df["Nilai"],
    bins=3,
    labels=["Rendah", "Sedang", "Tinggi"]
)
print(df)
equal_frequency.py
nilai = [40, 45, 50, 60, 65, 70, 75, 80, 85, 90]
df = pd.DataFrame({"Nilai": nilai})

# Equal frequency: 3 kelompok berisi sama banyak
df["Kategori"] = pd.qcut(
    df["Nilai"],
    q=3,
    labels=["Rendah", "Sedang", "Tinggi"]
)

print(df.to_string(index=False))
print(df["Kategori"].value_counts().sort_index())
Unsupervised vs Supervised Discretization
Unsupervised tidak melihat kolom target sama sekali; ia hanya melihat
distribusi nilai di kolom itu sendiri. Contoh: equal-width dan equal-frequency.
Supervised melihat fitur target, sehingga batas bin dipilih agar paling
membantu model membedakan kelas. Contoh: entropy-based discretization
(information gain pada decision tree).
Contoh intuitif: usia 17–80 tidak diperlakukan sebagai 63 nilai unik, melainkan
dikelompokkan menjadi Remaja, Dewasa, Lansia.
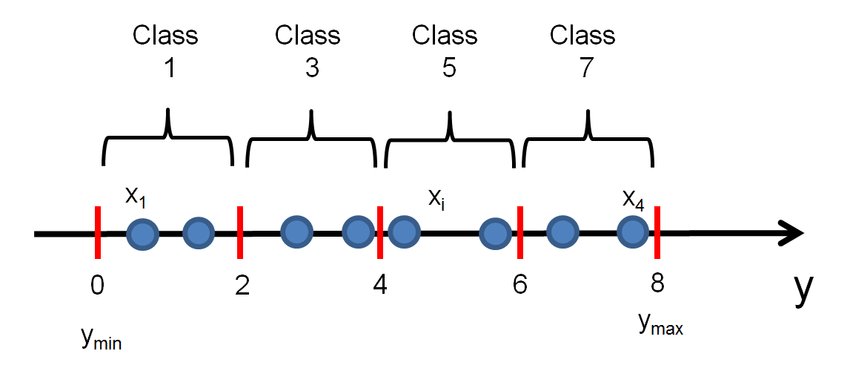
Gambar asli materi. Variabel kontinu y dipartisi menjadi empat kelas
berjarak sama antara y_min dan y_max;
titik-titik data (x₁, xᵢ, x₄) jatuh ke kelas berdasarkan intervalnya.
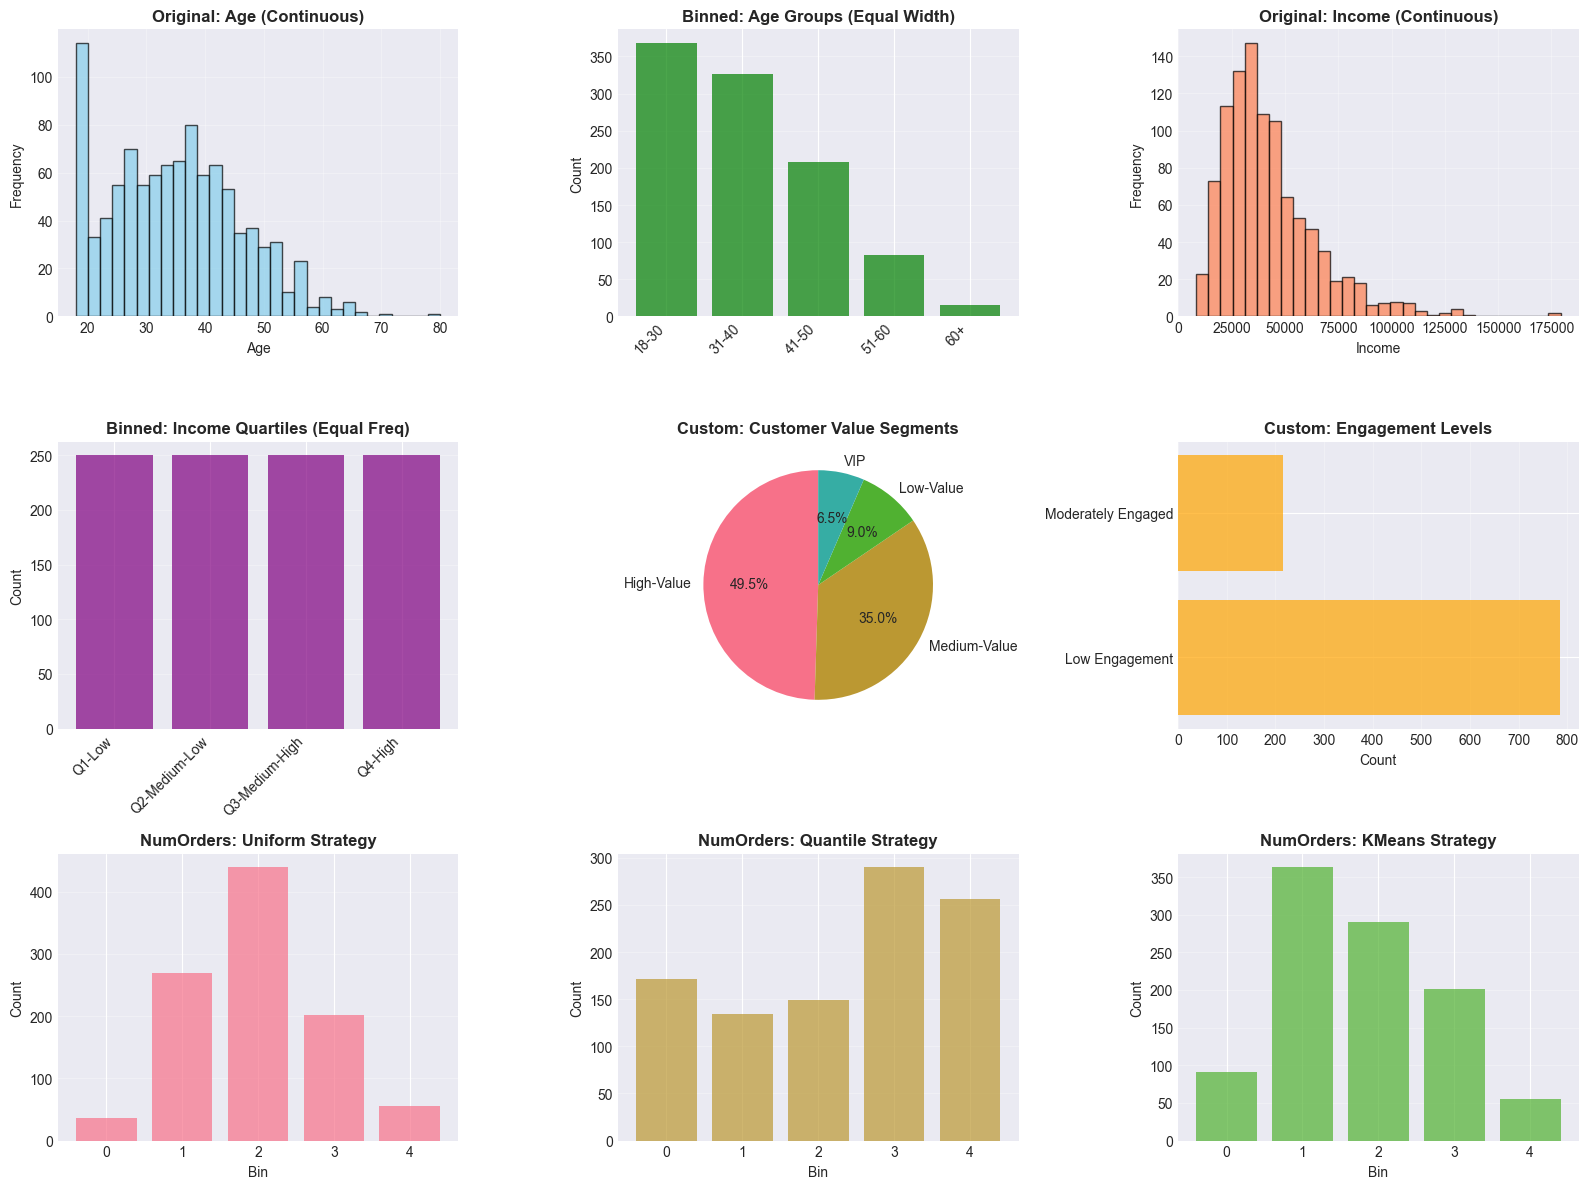
Gambar asli materi. Sembilan panel membandingkan distribusi asli (Age, Income) dengan
equal-width, equal-frequency/quartile, segmentasi kustom, serta tiga strategi binning
pada NumOrders: uniform, quantile, dan KMeans. Perhatikan bahwa uniform
menghasilkan hitungan sangat tidak rata, sedangkan quantile berusaha menyamakan jumlah.
Pemilihan Fitur & Reduksi Dimensionalitas
Tidak semua fitur membantu. Beberapa redundan, beberapa hanya menambah noise, dan sebagian
membuat model lambat serta sulit dijelaskan.
FILTER
Berdasarkan Statistik
Menilai fitur secara mandiri tanpa model: korelasi dengan target, chi-square,
mutual information, varians mendekati nol.
Cepat, tetapi mengabaikan interaksi antar fitur.
WRAPPER
Berdasarkan Kinerja Model
Mencoba kombinasi fitur dan menilai lewat model: forward selection,
backward elimination, recursive feature elimination (RFE).
Akurat, tetapi komputasi mahal.
EMBEDDED
Terintegrasi dalam Latihan
Seleksi terjadi saat model dilatih: regularisasi Lasso (L1) yang memaksa
koefisien nol, atau feature importance pada pohon keputusan.
Kompromi yang paling sering dipakai praktisi.
PCA: Meringkas Tanpa Membuang Terlalu Banyak
Principal Component Analysis mengubah fitur asli menjadi komponen baru yang
saling tidak berkorelasi, diurutkan berdasarkan variansi yang dijelaskan. Dengan mengambil
beberapa komponen pertama, dimensi turun drastis sementara sebagian besar informasi tetap terjaga.
Wajib standardisasi dulu, karena PCA sensitif terhadap skala.
Komponen tidak lagi punya makna asli — ini trade-off interpretabilitas.
Berguna untuk visualisasi data berdimensi tinggi (proyeksi ke 2D).
Variansi Terjelaskan
ilustrasi scree plot
PC1 menangkap porsi variansi terbesar, PC2 berikutnya, dan seterusnya. Titik "siku"
(elbow) biasanya menandai berapa komponen yang layak dipertahankan.
Kesimpulan unit ini. Dengan transformasi data, rekayasa fitur, dan agregasi,
dataset menjadi lebih siap menghasilkan wawasan yang baik dan model yang lebih akurat.
Inti keterampilannya bukan menghafal teknik, melainkan melihat informasi apa yang
tersembunyi di data mentah dan mengubahnya menjadi bentuk yang bisa dipakai model.
TUGAS STUDI KASUS
E-Commerce: Prediksi Pelanggan Akan Membeli Lagi
Anda seorang data scientist di perusahaan e-commerce. Dataset mentah transaksi berisi:
Transaction_ID, Customer_ID,
Transaction_Date, Product_Category,
Item_Price, Quantity,
Customer_Address.
Tujuannya membangun model churn/retention prediction.
1 · Feature Creation
Buat fitur prediktif seperti Total_Spend = Item_Price × Quantity,
jumlah transaksi, rata-rata nilai transaksi, dan jumlah kategori produk berbeda.
2 · Datetime Engineering
Ekstrak hari, bulan, kuartal, dan weekend flag; hitung recency dari
transaksi terakhir. Pola waktu sering menjadi sinyal kuat kebiasaan belanja.
3 · Text/Categorical
Alamat terlalu unik untuk dipakai langsung. Ekstrak kota dan
kode pos, atau turunkan jarak ke pusat distribusi sebagai fitur numerik.
07Judul Unit Label & Model
Membangun Model
Model adalah representasi matematis atau algoritmik dari proses belajar berdasarkan data,
dipakai untuk membuat prediksi atau keputusan. Ia dibangun dengan menganalisis pola pada
data latih, lalu dipakai pada data baru yang belum pernah dilihat.
Sebelum Model: Menentukan Label Data
Dalam supervised learning, label adalah target — hasil yang ingin diprediksi.
Fitur adalah variabel independen, label adalah variabel dependen.
JENIS 1
Binary Labels
Dua nilai: 0/1, Ya/Tidak, True/False.
Contoh: apakah email ini spam?
Logistic Regression
JENIS 2
Multi-Class Labels
Lebih dari dua kategori yang saling eksklusif.
Contoh: kucing, anjing, burung.
Random Forest
JENIS 3
Continuous Labels
Nilai numerik kontinu, tak terbatas pada kategori.
Contoh: harga rumah.
Linear Regression
Mengapa Label Penting?
Panduan model — label memberi tahu algoritma hubungan input→output yang dicari.
Evaluasi kinerja — tanpa label tidak ada cara mengukur seberapa baik prediksi.
Pelatihan & validasi — label dipakai menyesuaikan bobot, lalu menguji akurasi.
Label yang salah atau bias akan diwarisi model. Ini alasan quality control pada pelabelan
sama pentingnya dengan pemilihan algoritma.
Tiga Langkah Identifikasi Label
Pahami tujuan — jika tujuannya memprediksi harga rumah, labelnya adalah harga rumah.
Tinjau dataset — lihat kolom yang ada dan pahami tipe data tiap kolom.
Pilih kolom yang sesuai — kolom itu harus relevan dengan tujuan prediksi.
Program atau algoritma yang dirancang mengenali pola dalam data. Model dilatih dengan
data historis untuk memetakan input (fitur) ke output (label),
lalu dipakai memprediksi data baru.
Contoh sederhana: model pengenal gambar anjing/kucing memakai pola dari gambar berlabel
untuk menentukan kelas gambar baru.
Peran Model di Data Science & AI
Data Science
Pengambilan keputusan berbasis data: memprediksi tren penjualan, mengotomatisasi
klasifikasi teks, prediksi churn, deteksi anomali transaksi.
Artificial Intelligence
Memberi "kecerdasan" pada sistem: mengenali wajah, berbicara dalam bahasa manusia,
bermain game. Model juga memungkinkan adaptasi dari data yang terus diperbarui.
Siklus Pengembangan Model: Data Mentah → Prediksi
delapan tahap, berulang
01Pengumpulan Data
→
02Pre-processing
→
03Pemilihan Model
→
04Training
08Monitoring & Pemeliharaan
←
07Deployment
←
06Fine-tuning & Optimasi
←
05Evaluasi Model
1. Pengumpulan — data relevan dari berbagai sumber, terstruktur maupun tidak.
7. Deployment — pakai di produksi untuk data baru.
8. Monitoring — pantau performa; latih ulang bila data berubah.
Tahap 5–6 hampir selalu berulang beberapa kali. Tahap 8 sering diabaikan pemula, padahal
di sinilah model yang "bagus saat demo" bisa perlahan memburuk di produksi
(data drift).
Empat Paradigma Pembelajaran
PARADIGMA 1
Supervised Learning
Model dilatih dengan data yang sudah berlabel. Model belajar hubungan
input→output sehingga bisa memprediksi output untuk data baru.
RegresiKlasifikasi
Regresi memprediksi nilai numerik kontinu (harga, berat, suhu).
Contoh: dari luas bangunan, jumlah kamar, dan lokasi → prediksi harga rumah Rp500 juta.
Klasifikasi memprediksi kategori. Contoh: email masuk "spam" atau "bukan spam".
PARADIGMA 2
Unsupervised Learning
Data tanpa label. Tujuannya menemukan pola tersembunyi atau struktur:
clustering, asosiasi, dan pengurangan dimensi.
Contoh kasus: perusahaan ingin mengelompokkan pelanggan berdasarkan perilaku
belanja, tetapi belum tahu kategori apa yang ada. Unsupervised learning menemukan kelompok
pelanggan dengan perilaku serupa.
Perbedaan kunci: supervised menjawab "berapa/jenis apa?",
unsupervised menjawab "ada kelompok apa di data ini?".
PARADIGMA 3
Self-Supervised Learning
Model dilatih memakai sinyal pengawasan yang dihasilkan dari data itu sendiri,
bukan label dari manusia. Data biasanya diaugmentasi atau ditransformasi sehingga terbentuk
pasangan sampel: satu sebagai input, satu sebagai target.
Dua langkah: (1) selesaikan pretext task dengan pseudo-label untuk
menginisialisasi parameter, (2) lakukan tugas sebenarnya dengan supervised/unsupervised learning.
Contoh: masked language modeling (menebak kata yang disembunyikan),
contrastive learning (memaksimalkan kemiripan pasangan gambar yang sama),
autoencoder (merekonstruksi input).
PARADIGMA 4
Reinforcement Learning
Agen belajar melalui interaksi dengan lingkungan: mengambil aksi, menerima
reward atau penalty, lalu menyesuaikan strategi (policy) untuk memaksimalkan
reward kumulatif.
Tidak ada label "jawaban benar" — yang ada hanya umpan balik dari konsekuensi tindakan.
Contoh: agen bermain game, robot navigasi, penjadwalan sumber daya, optimasi rekomendasi.
Cara memilih paradigma: punya label? → supervised. Tidak punya, ingin menemukan
struktur? → unsupervised. Punya banyak data mentah tetapi label mahal? → self-supervised
(lalu fine-tune). Belajar lewat aksi dan konsekuensi? → reinforcement learning.
Sepuluh Algoritma Supervised Learning
Daftar ini bukan untuk dihafal, tetapi untuk dipetakan: mana yang cocok untuk regresi,
mana untuk klasifikasi, dan apa karakteristiknya.
L1 — bisa memaksa koefisien jadi nol (seleksi fitur)
ElasticNet
Gabungan L1 + L2
Support Vector Regression
Margin toleransi error (ε-tube)
Decision Tree Regression
Mudah dibaca, cenderung overfit tanpa pruning
Random Forest Regression
Banyak pohon + averaging; stabil
Gradient Boosting Regression
Pohon berurutan memperbaiki residual
KNN Regression
Rata-rata k tetangga terdekat; butuh scaling
XGBoost Regression
Gradient boosting teroptimasi; kuat di data tabular
Klasifikasi
Algoritma
Karakter Singkat
Logistic Regression
Probabilitas kelas via fungsi sigmoid
Support Vector Machine
Hyperplane dengan margin maksimum; kernel untuk non-linear
Decision Tree Classifier
Aturan if-then; sangat interpretable
Random Forest Classifier
Ensemble pohon; mengurangi variansi
K-Nearest Neighbors
Suara mayoritas k tetangga
Naïve Bayes
Cepat, asumsi independensi fitur
Gradient Boosting Classifier
Boosting bertahap; akurasi tinggi
AdaBoost
Menekankan sampel yang salah klasifikasi
XGBoost Classifier
Boosting regularisasi; sering jadi baseline kuat
Neural Network
Fleksibel; butuh data & tuning lebih banyak
Tidak ada algoritma terbaik secara universal (no free lunch).
Yang menang biasanya: data yang lebih baik, fitur yang lebih relevan, dan evaluasi yang jujur —
bukan sekadar algoritma yang lebih canggih.
CLUSTERING
K-Means: Cara Kerja
Tentukan jumlah cluster K.
Pilih K titik sebagai centroid awal (acak).
Tempatkan setiap titik ke cluster dengan centroid terdekat.
Hitung ulang centroid = rata-rata titik di cluster itu.
Ulangi langkah 3–4 sampai centroid tidak berubah signifikan.
Contoh: mengelompokkan pelanggan berdasarkan perilaku belanja agar strategi pemasaran
bisa dibedakan per kelompok.
Iterasi K-Means (K = 3)
iterasi 0 — centroid acak
Centroid (belah ketupat putih) bergerak ke pusat massanya. Proses berhenti ketika
penempatan titik tidak lagi berubah — artinya konvergen. Karena titik awal acak,
hasil bisa berbeda antar-run; praktik umum: n_init=10.
Hierarchical Clustering: Dendrogram
agglomerative (bottom-up)
Setiap penggabungan terjadi pada ketinggian yang menyatakan jarak antar cluster.
Memotong dendrogram pada ketinggian tertentu menghasilkan jumlah cluster yang diinginkan —
tanpa harus menentukan K di awal.
Dua Arah Pembentukan
Agglomerative (bottom-up): mulai dari setiap titik sebagai
cluster sendiri, gabungkan dua cluster paling mirip, ulangi sampai tersisa satu cluster besar.
Divisive (top-down): mulai dari seluruh data sebagai satu cluster,
pecah berdasarkan perbedaan terbesar, ulangi sampai tiap titik terpisah.
Contoh: mengelompokkan dokumen teks berdasarkan kesamaan isi untuk membangun hierarki topik.
Sepuluh Algoritma Unsupervised Learning
Algoritma
Kegunaan
Catatan
K-Means
Clustering partisional
Cepat; perlu tentukan K; sensitif outlier
Hierarchical Clustering
Clustering hierarkis
Dendrogram; tanpa K di awal; O(n²)
DBSCAN
Clustering berbasis kepadatan
Bisa menemukan bentuk arbitrer & menandai noise
Mean Shift
Clustering berbasis mode
Menentukan jumlah cluster sendiri
Gaussian Mixture Model
Clustering probabilistik
Soft assignment (peluang keanggotaan)
PCA
Reduksi dimensi
Komponen ortogonal, berbasis variansi
ICA
Pemisahan sinyal
Mencari komponen independen, bukan tak berkorelasi
t-SNE
Visualisasi dimensi tinggi
Bagus untuk 2D/3D; jarak global tidak akurat
Autoencoder
Representasi terlatih
Encoder–decoder; dasar deteksi anomali
Self-Organizing Map
Kuantisasi vektor
Memetakan data ke grid 2D topologi-terjaga
Contoh Notebook (dari Materi)
Materi menyediakan dua notebook Colab sebagai contoh praktik:
Supervised — regresi & klasifikasi.
Unsupervised — clustering.
Tautan asli tercantum pada slide 38 dan 44 materi (Google Colab).
Jika tautan tidak lagi dapat diakses, polanya tetap dapat direplikasi dengan
scikit-learn pada dataset contoh.
Kesimpulan Unit Ini
Pemilihan model menentukan hasil optimal, baik supervised maupun unsupervised.
Evaluasi (MSE, R², akurasi) menunjukkan di mana model perlu diperbaiki.
Visualisasi membantu memahami kinerja dan menyampaikannya ke audiens non-teknis.
Ini fondasi untuk topik lanjutan: tuning, deployment, dan pemantauan model di produksi.
08Judul Unit Mengevaluasi Model
Mengevaluasi Hasil Pemodelan
Evaluasi menentukan seberapa baik model bekerja pada data yang belum pernah dilihat.
Tanpa evaluasi yang tepat, model bisa tampak hebat saat dilatih tetapi gagal total saat dipakai.
ALASAN 1
Keandalan & Validitas
Keandalan: prediksi konsisten dan akurat pada berbagai set data, termasuk yang
tidak ada di data latih. Validitas: model benar-benar memprediksi apa yang
seharusnya, bukan memanfaatkan kebetulan dalam data.
ALASAN 2
Mendeteksi Over/Underfitting
Overfitting: model terlalu kompleks, menangkap noise — bagus di data latih,
buruk di data baru. Underfitting: model terlalu sederhana — buruk di keduanya.
ALASAN 3
Optimasi untuk Masa Depan
Metrik memberi umpan balik untuk tuning parameter atau mengganti algoritma, sekaligus
memastikan model layak masuk produksi.
Underfitting · Pas · Overfitting
garis model vs sebaran data
Cara mendeteksinya sederhana: bandingkan kinerja pada data latih dan data uji.
Jarak besar antara keduanya adalah tanda overfitting; keduanya buruk berarti underfitting.
Evaluasi Model Regresi
Regresi memprediksi nilai kontinu, sehingga metriknya mengukur seberapa jauh prediksi
meleset — dalam satuan asli, satuan kuadrat, atau persentase.
MAE — Mean Absolute Error
Rata-rata selisih absolut antara nilai sebenarnya dan prediksi.
MAE =1nΣ |yi − ŷi|
Memberi gambaran langsung kesalahan rata-rata tanpa penalti tambahan untuk
kesalahan besar. Satuannya sama dengan data asli, jadi paling mudah dijelaskan.
Contoh: harga asli Rp500 juta, prediksi Rp470 juta → error Rp30 juta.
MSE — Mean Squared Error
Rata-rata dari kuadrat selisih prediksi dan nilai aktual.
MSE =1nΣ (yi − ŷi)²
Memberi penalti lebih besar untuk kesalahan besar karena dikuadratkan.
Cocok ketika Anda ingin model sangat sensitif terhadap prediksi yang meleset jauh.
Error 2 → 4 · error 5 → 25 · error 20 → 400. Kesalahan besar jadi dominan.
Contoh Perhitungan: Tiga Observasi
aktual vs prediksi
Aktual
Prediksi
Error
Error²
|Error|
100
90
10
100
10
200
220
−20
400
20
300
290
10
100
10
Total |error| = 40 · Total error² = 600 · n = 3
MAE = 40 / 3
0
rata-rata meleset 13,33 satuan
MSE = 600 / 3
0
rata-rata kuadrat error
RMSE = √200
0
kembali ke satuan asli
Perhatikan hubungannya: RMSE ≥ MAE selalu benar. Jika RMSE jauh lebih tinggi
dari MAE, berarti ada beberapa prediksi dengan error sangat besar.
RMSE — Root Mean Squared Error
Akar kuadrat MSE, mengembalikan nilai ke satuan target asli.
RMSE = √MSE
Keunggulannya: mudah ditafsirkan (rupiah, kilogram, dan seterusnya) tetapi tetap
menghukum kesalahan ekstrem lebih berat daripada MAE.
MAPE — Mean Absolute Percentage Error
Rata-rata kesalahan dalam bentuk persentase.
MAPE =100%nΣ|yi − ŷi||yi|
Contoh: asli Rp500 juta, prediksi Rp450 juta → |500−450|/500 × 100% = 10%.
Jika rata-rata seluruh data 4,5%, artinya prediksi menyimpang sekitar 4,5% dari nilai sebenarnya.
Hati-hati jika nilai aktual mendekati nol — MAPE bisa meledak.
R² — Koefisien Determinasi
Mengukur proporsi variansi data target yang dapat dijelaskan model.
Berbeda dari MAE/RMSE: ia tidak mengukur besar error, melainkan seberapa baik model
menangkap pola.
R² = 1 −Σ (yi − ŷi)²Σ (yi − ȳ)²
Nilai
Interpretasi
1.00
Prediksi sempurna
0.90
Menjelaskan ~90% variasi
0.70
Menjelaskan ~70% variasi
0
Tidak lebih baik dari menebak rata-rata
< 0
Lebih buruk daripada prediksi rata-rata
Sebaran Nilai R²
semakin dekat 1 semakin baik
Contoh kasus
R² = 0.92
"Model menjelaskan sekitar 92% variasi harga rumah; 8% sisanya tidak dijelaskan."
R² tinggi tidak berarti model sempurna. Selalu laporkan bersama MAE atau RMSE agar
besaran error tetap terlihat.
Metrik
Arah
Arti Praktis
Kapan Dipakai
MAE
Semakin kecil semakin baik
Rata-rata besar kesalahan, satuan asli
Semua kesalahan dianggap sama penting
MSE
Semakin kecil semakin baik
Rata-rata kesalahan kuadrat
Butuh penalti besar untuk error besar (optimasi)
RMSE
Semakin kecil semakin baik
Kesalahan rata-rata dalam satuan asli
Ingin penalti error besar + mudah ditafsirkan
MAPE
Semakin kecil semakin baik
Rata-rata kesalahan dalam persen
Membandingkan skala berbeda / komunikasi bisnis
R²
Mendekati 1 semakin baik
Proporsi variansi yang dijelaskan
Menilai daya jelas model terhadap pola data
Membaca Satu Set Hasil
Metrik
Hasil
MAE
Rp25 juta
MSE
900
RMSE
Rp30 juta
R²
0,92
MAPE
5,5%
Model memprediksi harga rumah dalam juta rupiah.
Interpretasinya
MAE Rp25 juta — rata-rata prediksi meleset Rp25 juta dari harga sebenarnya.
MSE 900 — rata-rata kuadrat kesalahan; lebih berguna untuk perhitungan model daripada interpretasi langsung karena satuannya kuadrat.
RMSE Rp30 juta — kesalahan umum sekitar Rp30 juta, dengan penalti lebih tinggi untuk kesalahan besar. RMSE > MAE menandakan ada beberapa error ekstrem.
R² 0,92 — 92% variasi harga dijelaskan oleh fitur seperti luas bangunan, luas tanah, lokasi, dan jumlah kamar.
MAPE 5,5% — jika harga sebenarnya Rp500 juta, rata-rata kesalahan ≈ 500 × 5,5% = Rp27,5 juta.
Klasifikasi memprediksi kategori, sehingga metriknya menghitung jenis kesalahan —
bukan sekadar berapa banyak yang benar. Di sinilah akurasi sering menipu.
Accuracy
Proporsi prediksi benar dari total prediksi.
TP + TNTP+TN+FP+FN
Menipu pada data tidak seimbang.
Precision
Dari semua yang diprediksi positif, berapa yang benar-benar positif?
TPTP + FP
Penting saat biaya false positive tinggi.
Recall
Dari semua kasus positif yang sebenarnya, berapa yang tertangkap?
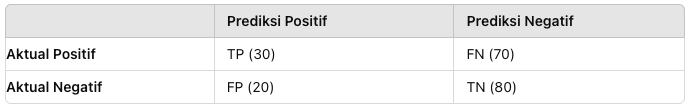
Empat sel ini adalah sumber semua metrik klasifikasi. Dari sini:
akurasi 55%, precision 60%, recall 30%, F1 40%.
Menghitung dari Matriks yang Sama
Metrik
Perhitungan
Hasil
Accuracy
(30 + 80) / 200
55%
Precision
30 / (30 + 20)
60%
Recall
30 / (30 + 70)
30%
Specificity
80 / (80 + 20)
80%
F1-Score
2·(0.6·0.3)/(0.6+0.3)
40%
Contoh kegagalan akurasi: model ini "benar" 55% — terlihat lumayan.
Tetapi ia hanya menangkap 30 dari 100 kasus positif. Untuk skrining penyakit,
ini berbahaya: 70 kasus lolos.
Gambar asli materi. Bentuk tabel confusion matrix sebagaimana disajikan:
baris = aktual, kolom = prediksi. Perhatikan letak FN (aktual positif, diprediksi negatif) —
inilah kesalahan yang paling mahal dalam diagnosis medis.
ROC Curve & AUC
trade-off TPR vs FPR di berbagai threshold
Setiap titik pada kurva adalah satu nilai threshold. Menurunkan threshold menaikkan recall
tetapi juga menaikkan false positive rate. AUC merangkum seluruh kurva menjadi
satu angka: 0.5 = acak, 1.0 = sempurna.
Membaca ROC
TPR (recall) = TP / (TP + FN) — proporsi positif yang tertangkap.
FPR = FP / (FP + TN) — proporsi negatif yang salah dituduh positif.
FPR =FPFP + TN
AUC ≈ 0.5 — tidak lebih baik dari menebak acak.
AUC 0.7–0.8 — cukup baik.
AUC 0.8–0.9 — baik.
AUC > 0.9 — sangat baik (periksa kebocoran data!).
AUC berguna untuk membandingkan model tanpa mengunci threshold tertentu.
Gambar asli materi. Definisi False Positive Rate — perhatikan bahwa
penyebutnya adalah seluruh aktual negatif, bukan total data.
FAKTOR 1
Konteks Aplikasi
Deteksi penyakit serius → recall lebih penting, karena melewatkan kasus
positif jauh lebih berbahaya daripada beberapa alarm palsu.
FAKTOR 2
Ketidakseimbangan Data
Jika 99% data negatif, model yang selalu menebak "negatif" mendapat akurasi 99% tetapi
tidak berguna. Gunakan precision, recall, atau F1.
FAKTOR 3
Trade-off
Menaikkan recall biasanya menurunkan precision. F1 dipakai untuk menyeimbangkan keduanya;
pilihan akhir tetap bergantung biaya masing-masing jenis kesalahan.
Aturan praktis. Laporkan lebih dari satu metrik. Akurasi saja tidak cukup;
selalu sertakan confusion matrix agar jenis kesalahan terlihat. Dan pastikan evaluasi dilakukan
pada data uji yang benar-benar belum pernah dilihat model.
Kesimpulan unit ini. Metrik evaluasi berbeda untuk regresi dan klasifikasi, dan
pemilihannya harus mengikuti tujuan aplikasi. Dengan evaluasi yang jujur kita bisa memutuskan
apakah model layak dipakai, di mana ia lemah, dan apa yang perlu diperbaiki — bukan sekadar
memamerkan satu angka yang terlihat bagus.